
유전체 분석에서 정밀 유전자편집까지:
양자-AI-HPC 하이브리드 연구전략
우상욱 ㈜팜캐드 대표이사, 국립부경대학교 교수
1. AI·양자컴퓨팅 최신 동향
유전자편집 기술의 경쟁력은 이제 DNA를 얼마나 정교하게 절단하고 치환할 수 있는가에만 좌우되지 않는다. 수많은 유전체 변이 가운데 어떤 유전자를 표적으로 삼을지, 여러 표적의 조합이 원하는 형질에 어떠한 영향을 미칠지, 편집 이후 예상하지 못한 부작용이 발생할 가능성은 없는지를 사전에 판단하는 능력이 더욱 중요해지고 있다. 이 과정에서 인공지능(AI)은 유전체 해석과 설계의 핵심 기술로 이미 자리 잡았다.
최근 주목받고 있는 양자컴퓨팅은 기존 컴퓨팅 기술의 한계를 넘어, 복잡한 조합최적화 문제의 해결과 고차원 데이터의 효율적인 표현 및 처리를 위한 새로운 계산 패러다임으로 신약·바이오 분야에서 활발히 연구되고 있다. 기존의 유전자편집 연구는 전장유전체 연관분석(Genome-Wide Association Study, GWAS), 단일염기다형성(Single Nucleotide Polymorphism, SNP) 분석 및 양적형질좌위(Quantitative Trait Locus, QTL) 분석, 유전자 기능 검증, CRISPR–Cas 편집과 표현형 평가가 상대적으로 분리되어 진행되었다.
최근에는 이러한 단계를 하나의 예측·설계·검증 순환 과정으로 통합하는 흐름이 나타나고 있다. 이러한 접근에서는 대규모 유전체 데이터에서 후보 표적을 발굴한 뒤 AI로 변이 효과와 가이드 RNA(gRNA)의 활성을 예측하고, 실험 결과를 다시 학습 데이터로 반영해 다음 편집 설계를 개선한다.
양자컴퓨팅의 적용 분야는 AI와 다소 다르다. AI가 방대한 생물학적 데이터에서 예측 규칙을 학습한다면, 양자컴퓨팅은 특정 수학적 구조를 가진 최적화 문제의 탐색, 양자 커널에 의한 데이터 표현, 분자·전자 구조의 정밀 계산 등에서 잠재력을 가진다. 양자 어닐링(quantum annealing), 변분 양자 알고리즘, 양자 커널 기법이 대표적이다. 그러나 현재의 양자 프로세서는 큐비트 수, 연결성, 잡음 및 데이터 입력 비용의 제약을 받으며, 유전체 전체를 곧바로 양자컴퓨터에 올리는 방식은 실용적이지 않다.
따라서 실제 연구개발에서는 고전 통계와 AI로 후보 영역을 충분히 축소하고, 양자 알고리즘을 선택된 부분문제에 적용하는 하이브리드 접근이 합리적이다. 유전체 마커 분석과 유전체 선발(genomic selection)은 특정 형질을 예측하거나 우수 개체를 선택하는 기술인 반면, 유전자편집(genome editing)은 DNA 서열을 실제로 변경하는 기술이다. 마커 분석에서 성과를 보였다는 사실만으로 편집 효율이 개선되었다고 해석할 수는 없다. 다만, 이러한 분석은 어떤 유전자와 조절영역을 편집할지 결정하는 중요한 근거를 제공한다.
2. 양자컴퓨팅 최적화 기술
- 조합 폭발의 문제를 최적화 문제로 전환
내병성·생산성·환경 스트레스 저항성과 같은 복합 형질은 다수의 유전자와 유전적 상호작용에 영향을 받는다. 여기에 표적 간 상호작용, 편집 가능성, 오프타깃(off-target) 위험과 생물학적 제약을 함께 고려하면 탐색 공간은 기하급수적으로 커진다. 따라서 단순히 개별 유전자의 중요도 순위를 매기는 것을 넘어 후보들의 조합을 평가하는 최적화 체계가 필요하다.
양자 어닐링과 양자영감(quantum-inspired) 최적화 기술은 이러한 문제를 QUBO(Quadratic Unconstrained Binary Optimization), 즉 이차 비제약 이진 최적화 문제로 표현해 다룬다. 각 후보 유전자 또는 SNP 선택 여부를 이진 변수로 표현하고, 편집 표적의 유익성은 보상하고 위험성과 중복성은 벌점으로 부여한다. 단, 실제 생물학적 효과가 복잡한 비선형 고차 상호작용에 의존한다면 이를 QUBO로 근사·변환하는 과정 자체가 하나의 핵심 연구 과제이다.
- SNP·편집 표적 선정의 QUBO 설계
후보 표적 i의 선택 여부를 xᵢ∈{0,1}로 나타내고 각 편집 표적의 질병 저항성 기여도와 표적 간 상호작용, 편집 난이도 및 오프타깃 위험을 수치화할 수 있다. 목적함수는 편집 표적 집합의 예상 이득을 최대화하면서 지정된 표적 수를 유지하고, 위험한 조합을 억제하도록 설계한다. 개념적으로 아래의 수식을 사용할 수 있다.
최소화 E(x) = −∑ᵢ aᵢxᵢ −∑ᵢ<ⱼ bᵢⱼxᵢxⱼ + λ(∑ᵢxᵢ−K)² + μ∑ᵢ rᵢxᵢ |
여기서 aᵢ는 개별 표적의 예측 이득, bᵢⱼ는 표적 간 상호작용, K는 선택할 표적 수, rᵢ는 편집 위험 또는 비용이다. λ와 μ는 제약 및 위험에 대한 가중치다. 이 수식은 이미 유전자편집 분야에서 양자 우위가 확인된 표준 기법이 아니라, 실험적으로 검증할 수 있는 연구 설계 예시다. 계수 역시 GWAS, 다중오믹스, 유전자 기능 정보 등에서 신뢰성 있게 추정해야 한다.
- 양자 커널·양자기계학습과 고전 AI의 역할 분담
양자기계학습(Quantum Machine Learning, QML)은 유전체 변수를 양자 상태에 부호화하고, 양자 상태 사이의 유사도를 커널로 계산하거나 변분 회로의 매개변수를 학습한다. 예컨대, 양자 서포트 벡터 머신(Quantum Support Vector Machine, QSVM)은 커널 K(x,y)=|⟨Φ(y)| Φ(x)⟩|²를 이용해 고차원 특징 간 관계를 표현한다. 이러한 방식은 복잡한 SNP–표현형 관계를 표현할 가능성을 보여주지만, 많은 샘플을 대상으로 커널 행렬을 계산하고 양자 회로를 실행하는 데 드는 비용을 고려하면 항상 빠르거나 정확한 것은 아니다.
실용적 파이프라인은 ① 전체 유전체 데이터의 품질관리 및 통계·AI 분석, ② 후보 SNP·유전자 및 조절서열 선별, ③ 제한된 후보군의 QUBO 또는 양자 커널 설계, ④ 고전 알고리즘·양자영감 알고리즘·QPU(Quantum Processing Unit)의 성능 비교, ⑤ 선정한 편집 표적의 CRISPR 설계 및 실험 검증으로 구축할 수 있다. 특히 학습·검증 자료를 엄격히 분리하고 개체 간의 유전적 상관관계와 집단구조에 따른 편향(bias)을 점검해야 한다.
실제 연구 성과를 위해서는 동일한 데이터, 양자컴퓨팅 실행 예산과 하이퍼파라미터 탐색 조건에서 Random Forest, 기존 SVM, 최신 딥러닝 결과와 비교해야 한다. 대규모 원시 유전체는 보안 환경에 보관하고, 외부 QPU에는 필요한 축약 변수와 계수만 전달하는 운영 방식도 고려할 만하다.
3. AI·양자컴퓨팅의 유전체 편집 사례
사례 1 | 토마토 내병성 예측: 편집 표적 발굴의 전 단계
Albert 등은 토마토 잎마름병 관련 43,342개 SNP에서 주요 30개 마커를 선별한 뒤, 단열 양자기계학습 회귀(Adiabatic Quantum Machine Learning Regression, AQMLR)와 다층 퍼셉트론(Multi-Layer Perceptron, MLP)을 비교했다[1].
총 4,000개 시료 중 2,800개를 학습에, 1,200개를 시험에 사용했으며, AQMLR의 결정계수 R²가 0.812로 MLP의 0.533보다 높았다. 두 방법의 예측 오차를 나타내는 RMSE(평균제곱근오차)는 각각 0.547과 1.265로 보고되었다. RMSE는 실제 값과 예측값의 차이를 나타내는 지표로, 값이 작을수록 예측 정확도가 높다는 의미이다. 이 연구에서는 질병의 심각도를 0에서 1 사이의 값으로 표현하였다. 연구의 주요 성과는 질병과 관련된 유전적 마커를 선별하고, 이를 이용해 질병의 심각도를 예측할 수 있음을 보인 것이다.
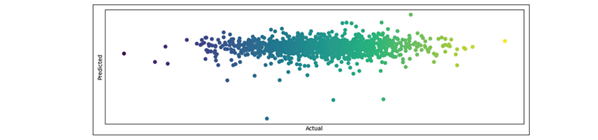
<그림 1> AQMLR을 이용한 토마토 병 저항성 예측 결과
유전적 마커(SNP)를 기반으로 실제 병 심각도와AQMLR 모델의 예측값을 비교한 산점도이다. AQMLR 모델은 R² = 0.812, RMSE = 0.547을 기록하여 기존 MLP 모델(R² = 0.533, RMSE = 1.265)보다 높은 예측 성능을 나타냈으며, 유전적 마커와 양자 머신러닝을 결합한 식물 병 저항성 예측의 가능성을 보여준다.
사례 2 | AI가 직접 설계한 편집 효소: OpenCRISPR-1
유전자편집에 직접 연결되는 검증 사례는 AI가 설계한 OpenCRISPR-1 효소다. Ruffolo 등은 대규모 CRISPR 서열 학습으로 새로운 Cas 유사 단백질을 생성하고, 인간 세포에서 편집 활성을 확인했다[2]. 미국 바이오기업 Profluent Bio 연구진이 개발한 이 효소는 인공지능을 활용하여 설계되었다.
대규모 미생물 유전체 및 메타유전체 데이터에서 약 124만 개의 CRISPR-Cas 유전자 집합을 수집하고, 약 5억 개의 단백질 서열로 사전 학습된 ProGen2 기반 단백질 언어모델(Protein Language Model)을 활용하였다. 이후 CRISPR-Cas 단백질 서열 데이터로 미세조정(Fine-tuning)을 수행하여 새로운 Cas 단백질 서열을 생성하였으며, 별도의 Encoder–Decoder 기반 모델을 이용해 Cas9 단백질에 적합한 gRNA도 설계하였다. 생성된 단백질의 구조적 특성을 AlphaFold2로 분석하고, 인간 HEK293T 세포에서 유전자편집 효율과 비표적 효과(Off-target effect)를 실험적으로 검증하였다.
그 결과, AI가 설계한 OpenCRISPR-1은 기존 SpCas9 대비 표적 편집률(On-target editing rate)이 47.1%에서 56.4%로 높게 나타났으며, 시험한 비표적 위치에서의 편집률은 6.1%에서 0.32%로 약 95% 감소하였다. 또한, DNA 이중가닥 절단 없이 특정 염기를 교정하는 염기편집(Base Editing)에도 적용할 수 있음을 확인하였다. 이를 통해 인공지능이 기존 유전체 분석과 기능 예측을 넘어 실제 유전자편집에 사용되는 효소를 직접 설계하고 성능을 개선하는 데 활용될 수 있음을 입증하였다.

<그림 2> AI로 생성된 Cas9 단백질과 천연 Cas9의 구조적 특성 비교
(a) 아미노산 서열 차이에도 불구하고 높은 구조 예측 신뢰도(pLDDT)를 보임
(b) 실험적으로 규명된 단백질 구조와 높은 유사성(TM-score)을 나타냄
(c) 주요 단백질 도메인의 분포와 서열 유사성이 천연 Cas9과 비슷함
(d) HNH, 표적 인식, PAM 상호작용 및 RuvC 유사 도메인의 구조적 유사성을 확인함
사례 3 | AlphaGenome 연구: 변이 기능 예측 모델
2026년 Nature에 게재된 AlphaGenome 연구는 이러한 변화를 보여준다[3]. Google DeepMind에서 개발한 AlphaGenome은 최대 약 100만 염기쌍(1Mb)의 DNA 서열을 입력받아 다양한 유전체 기능을 예측하는 인공지능 모델이다. CNN과 U-Net 기반의 Encoder–Decoder 구조에 Transformer를 결합하여 설계되었으며, 인간과 생쥐의 DNA 서열 및 기능 유전체 실험 데이터를 활용해 학습되었다.
특히 사전학습(Pretraining)과 지식 증류(Knowledge Distillation) 기법을 적용하여 예측 성능과 계산 효율을 높였다. 이를 통해 유전자 발현, RNA 스플라이싱, 전사인자 결합, 염색질 접근성 등 11개 유형의 생물학적 신호를 예측할 수 있다. 또한, 정상 DNA 서열(Reference)과 변이 DNA 서열(Alternative)을 각각 입력하고, 두 예측 결과의 차이를 비교함으로써 특정 유전적 변이가 생물학적 기능에 미치는 영향을 분석하였다.
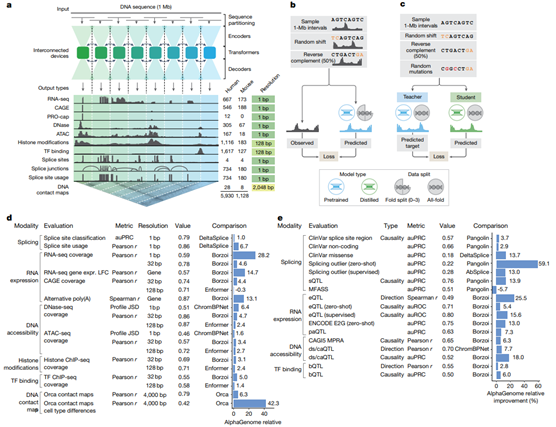
<그림 3> AlphaGenome의 모델 구조 및 유전변이 영향 예측 성능
(a) 1Mb DNA 서열을 입력받아 Encoder–Transformer–Decoder 구조를 통해 유전자 발현, RNA 스플라이싱, 염색질 접근성 등 11개 유형의 유전체 기능을 예측하는 모델 구조
(b) 유전체 실험 데이터 기반 사전학습
(c) Teacher–Student 기반 지식 증류 과정을 나타냄
(d) 유전체 기능 예측 24개 중 22개에서 우수한 성능을 보임
(e) 유전변이 영향 예측 26개 중 25개에서 동등하거나 우수한 성능을 보임
4. 기술 혁신과 향후 전망
AI와 양자컴퓨팅의 융합은 유전자편집 연구를 개별 유전자 중심의 시행착오 방식에서 벗어나, 다수 후보의 기능·상호작용·위험을 종합적으로 고려하는 설계형 연구로 전환할 잠재력이 있다. 그러나 기술적 성숙도는 서로 다르다. AI는 이미 변이 기능 예측과 편집 효소 설계에서 실험적 성과를 내고 있지만, 양자컴퓨팅은 주로 전처리된 제한 규모의 최적화 및 예측 문제에서 활용 가능성을 탐색하는 단계다.
첫째, 표적 유전자와 조절영역 선정의 정밀화
유전체 서열 외에도 유전자 발현, 단백질 상호작용, 환경 스트레스 조건을 함께 분석해 실제 표현형을 좌우하는 원인 유전자와 조절영역을 구별할 필요가 있다. AI 기반 기능 예측은 이 과정을 돕고, 양자·양자영감 최적화는 후보 조합의 다목적 탐색에 시험적으로 접목할 수 있다. 질병 저항성을 높이더라도 수량, 생장 속도, 품질이 동시에 악화되지 않도록 복수 형질의 균형을 평가해야 한다.
둘째, 편집 효율·안전성·전달성을 함께 최적화
실제 CRISPR 개발에서는 높은 온타깃(On-target) 활성만으로 충분하지 않다. 오프타깃 편집, 예기치 않은 DNA 변화, 세포 유형에 따른 성능 변동, 전달체 적합성 및 개체 수준의 표현형까지 함께 평가해야 한다. AI는 gRNA 선택, Cas 단백질 공학, 염기편집 및 프라임편집 시스템의 설계에 도움을 줄 수 있다. 양자 최적화가 적용된다면 생물학적 안전성 기준을 수학적 제약조건에 반영하는 것이 중요하다.
셋째, 객관적 벤치마크와 실험 재현성
향후 연구의 설득력은 실험에 기반한 검증에서 나온다. 우선 고전적 최신 기준모델을 정하고, 같은 데이터·예산·시험 조건에서 예측력, 편집 성공률, 오프타깃 빈도, 계산비용과 실험 검증 비용을 비교해야 한다. 양자 회로를 단순히 시뮬레이션했는지, 실제 QPU에서 실행했는지도 구분해 보고해야 한다. QUBO 계수의 생물학적 타당성과 선택 표적의 실제 인과성을 검증하는 절차 역시 필수다.
넷째, 농업·바이오산업을 위한 단계적 상용화(Quantum-AI-HPC hybrid 시스템)
가장 현실적인 추진 전략은 고전 AI와 HPC(High Performance Computing)를 활용해 대규모 데이터를 분석하고 편집 후보를 줄인 다음, 일부 조합 최적화 문제에 양자·양자영감 솔버(solver)를 도입해 소규모 QPU 실험으로 성능을 검증하는 것이다. 그 결과를 CRISPR 설계와 세포·식물체 수준의 편집 실험에 연결해야 한다. 원시 유전체 데이터의 접근 통제, 안전성 평가, 윤리 및 규제 기준도 초기부터 함께 설계할 필요가 있다.
궁극적으로 중요한 것은 양자컴퓨터가 유전자를 직접 편집하는 것이 아니다. AI가 생물학적 의미를 해석하고, 최적화 알고리즘이 수많은 설계 대안을 체계적으로 탐색하며, 실제 편집 실험이 가설을 검증하는 선순환 구조를 만드는 일이다. 이러한 양자–AI-HPC 하이브리드 전략이 축적될 때 유전자편집의 정확성, 속도와 연구개발 효율을 함께 높일 수 있을 것이다.
<참고문헌>
1. Albert, E. T. A., Bille, N. H., Martin, B. J., & Leonard, N. M. E. (2023). Integrating genetic markers and adiabatic quantum machine learning to improve disease resistance-based marker assisted plant selection. Journal of Scientific Agriculture, 7, 63–76. https://doi.org/10.25081/jsa.2023.v7.8556
2. Ruffolo, J. A., et al. (2025). Design of highly functional genome editors by modelling CRISPR–Cas sequences. Nature, 645, 518–525. https://doi.org/10.1038/s41586-025-09298-z
3. Avsec, Ž., Latysheva, N., Cheng, J., et al. (2026). Advancing regulatory variant effect prediction with AlphaGenome. Nature, 649, 1206–1218. https://doi.org/10.1038/s41586-025-10014-0
* 본 기고문은 과학기술정보통신부에서 시행한 「유전자편집·제어·복원기반기술개발사업」수행의 일환으로 작성되었습니다.
* 본 내용은 유전체편집연구지원사무국(GERC)의 의견과 다를 수 있음을 밝힙니다.
* 인용, 발표하실 때에는 반드시 출처를 밝혀주시기 바랍니다.